
Lokale KI und Datenschutz: Was Ollama und Co. trotzdem nach außen senden

Nehmen wir an, Sie leiten die IT eines Maschinenbauers mit 300 Beschäftigten. Ihr Team hat auf einem GPU-Server Ollama installiert, darüber läuft Open WebUI, und die Konstruktion durchsucht damit Wartungshandbücher und Prüfberichte. Die Geschäftsführung hat zugestimmt, weil ein Argument überzeugt hat: Die Daten verlassen das Haus nicht.
Für die Chats selbst versprechen das auch die Hersteller. Ollama schreibt in seinem FAQ, dass der Anbieter bei lokaler Ausführung weder Prompts noch Daten zu sehen bekommt, und LM Studio hält in seiner Dokumentation zum Offline-Betrieb fest, dass nichts, was Sie im Chat eingeben, das Gerät verlässt. Rund um den Chat passiert allerdings eine ganze Menge, und einige Standardeinstellungen gehen weiter, als viele annehmen.
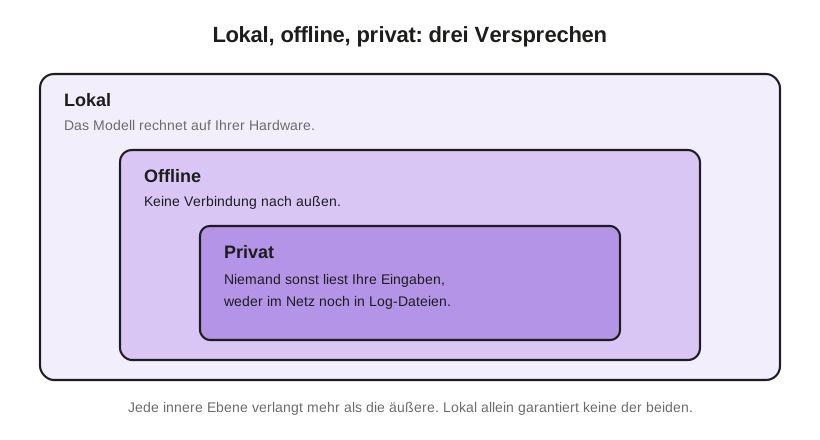
Deshalb lohnt es sich, drei Begriffe auseinanderzuhalten. Lokal heißt, das Modell rechnet auf Ihrer Hardware. Offline heißt, die Software baut keine Verbindung nach außen auf. Privat heißt, niemand außer Ihnen kann lesen, was eingegeben wurde. Ein System kann lokal sein, ohne offline zu sein, und offline, ohne privat zu sein.
Was eine lokale Installation nach außen meldet
Der Ollama-Server holt sich beim Start Informationen von ollama.com, darunter Modellempfehlungen. Im Quellcode ist dafür ein Aktualisierungsintervall von vier Stunden hinterlegt. Die Desktop-App prüft zusätzlich regelmäßig auf Updates. Ein GitHub-Issue, das sich einen Schalter zum Abschalten automatischer Updates wünscht, ist seit Juli 2024 offen.
Bei LM Studio sieht es ähnlich aus. Laut Dokumentation braucht die App eine Netzwerkverbindung, um verfügbare Laufzeitumgebungen zu prüfen und herunterzuladen, ebenso für Updates und für die Modellsuche.
Inhalte aus Ihren Chats stecken in diesen Anfragen nicht. Sie verraten aber, dass in Ihrem Netz ein KI-Server läuft, und bei jedem Download auch, welche Modelle Sie interessieren. Je nach App sieht das Hugging Face, die Registry des Herstellers oder ein Speicherdienst, über den die Dateien ausgeliefert werden. Für die meisten Unternehmen ist das vertretbar. Bewusst entscheiden sollte man es trotzdem, gerade wenn der Server in einer Umgebung steht, die eigentlich keinen Internetzugang haben darf.
Cloud-Modelle mit lokalem Namen
Ollama bietet inzwischen auch Cloud-Modelle an. Wer im Client angemeldet ist, ruft sie mit einem Namen wie gemma4:cloud auf, also im gleichen Format wie ein lokales Modell. Heruntergeladen wird dabei nichts, die Anfrage geht an die Server von Ollama. Laut FAQ werden die Inhalte dort verarbeitet, aber weder gespeichert noch für Training verwendet.
Das Risiko liegt weniger im Angebot selbst als in der Verwechslung. Ein Coding-Assistent oder ein Skript, das jemand einmal auf ein Cloud-Modell umgestellt hat, schickt Quellcode oder Dokumente nach draußen, während alle im Team von einem lokalen System ausgehen. Prüfen Sie daher Modellliste und Integrationen auf das Suffix cloud.
Wer die Cloud-Funktionen nicht braucht, schaltet sie ab: mit der Umgebungsvariable OLLAMA_NO_CLOUD=1 oder indem Sie in ~/.ollama/server.json den Schlüssel disable_ollama_cloud auf true setzen. Laut FAQ entfallen damit Cloud-Modelle und Websuche. Noch sauberer ist es, den Server gar nicht erst mit einem Ollama-Konto anzumelden.
Die gefährlichste Zeile: OLLAMA_HOST=0.0.0.0
Zurück zum Maschinenbauer: Damit Open WebUI und die Laptops der Konstruktion den Server erreichen, hat Ihr Team OLLAMA_HOST=0.0.0.0 gesetzt. So steht es in vielen Anleitungen. Ollama lauscht standardmäßig nur auf 127.0.0.1:11434, mit vier Nullen dagegen auf allen Netzwerkschnittstellen.
Eine Anmeldung kennt die lokale API von Ollama nicht, und wer den Port erreicht, kann Modelle auflisten, laden, löschen und auf Ihrer GPU rechnen lassen. Dazu kommt ein zweiter Effekt, den der Quellcode zeigt: Ollama prüft den Host-Header jeder Anfrage, um DNS Rebinding (eine Webseite gibt sich gegenüber dem Browser als lokaler Server aus) abzuwehren. Diese Prüfung greift aber nur, solange der Server an die Loopback-Adresse gebunden ist. Mit 0.0.0.0 entfällt sie.
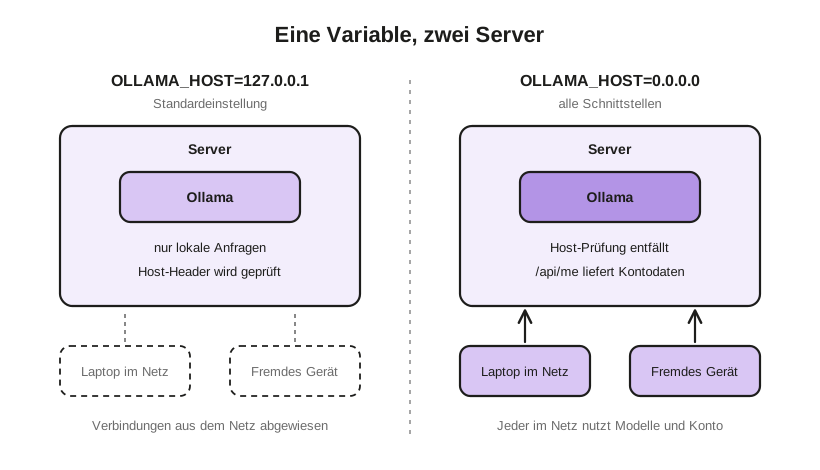
Ist der Server bei Ollama angemeldet, wird es unangenehmer. Der Endpunkt /api/me reicht die Anfrage mit den hinterlegten Anmeldedaten des Servers an ollama.com weiter und liefert die Kontodaten zurück. Jedes Gerät, das den Port erreicht, kann außerdem Cloud-Modelle auf Ihr Kontingent laufen lassen.
Mit Docker kommt ein weiterer Fallstrick hinzu. Die offizielle Anleitung startet den Container mit -p 11434:11434, was den Port auf allen Schnittstellen veröffentlicht. Laut Docker-Dokumentation werden solche Pakete umgeleitet, bevor Regeln von ufw greifen. Die Firewall auf dem Host schützt hier also nicht. Abhilfe schafft -p 127.0.0.1:11434:11434.
Auch llama.cpp verdient einen Blick. Dessen llama-server lauscht zwar standardmäßig nur lokal, spiegelt laut README aber jeden Origin-Header zurück. Eine Webseite, die den Browser zum lokalen Port durchbringt, könnte das Modell nutzen und die Antworten lesen. Der Parameter --api-key schließt diese Lücke mit wenig Aufwand.
Wie viele Server offen im Netz stehen
SentinelLABS und Censys haben über 293 Tage hinweg 175.108 öffentlich erreichbare Ollama-Hosts in 130 Ländern gezählt (Stand März 2026). Mehr als 48 % davon bieten Tool Calling an, können also Code ausführen oder externe Systeme ansprechen. Laut den Forschern genügt eine einzige Konfigurationsänderung, um einen Ollama-Server öffentlich erreichbar zu machen.
Intruder hat im März 2026 über 5.000 exponierte Ollama-Server mit einem harmlosen „Hello“ angefragt. 31 % antworteten ohne jede Authentifizierung. Und Kaspersky berichtete im Mai 2026 über einen Honeypot (Köder-Server), den ein Forscher als privaten KI-Server getarnt ins Netz gestellt hatte. Der Internetscanner Shodan fand ihn nach drei Stunden, im folgenden Monat gingen mehr als 113.000 Anfragen ein. Die Angreifer wollten vor allem Rechenleistung abzweigen und Zugangsdaten aus .env-Dateien abgreifen.
Was auf der Festplatte liegen bleibt
Privat bedeutet auch, dass Prompts nicht unbemerkt in Dateien landen. Ollama speichert jede Eingabe einer interaktiven ollama run-Sitzung als Klartext in ~/.ollama/history. Mit /set nohistory in der Sitzung oder der Variable OLLAMA_NOHISTORY=1 lässt sich das abstellen.
Bei Desktop-Apps im Servermodus lohnt ein Blick in die Log-Verzeichnisse. LM Studio etwa zeigt über lms log stream die Texte, die an das Modell gehen und von ihm zurückkommen. Prüfen Sie, ob und wo solche Protokolle auf Ihrem System gespeichert werden und wer sie lesen darf.
Checkliste für Ihren lokalen KI-Server
- Ollama an
127.0.0.1binden und den Zugriff aus dem Netz über einen Reverse Proxy mit Anmeldung oder über ein VPN führen. - In Docker Ports nur mit
127.0.0.1:davor veröffentlichen. OLLAMA_NO_CLOUD=1setzen oder den Server von jedem Ollama-Konto abmelden.- Modellliste und Integrationen auf Cloud-Modelle prüfen.
llama-serverimmer mit--api-keystarten.- Verlaufsdateien und Server-Logs prüfen, abschalten oder regelmäßig löschen.
- Ausgehende Verbindungen des Servers per Firewall auf das beschränken, was Sie bewusst erlauben.
Wie Sie einen solchen Server von Grund auf einrichten, zeigt unsere Schritt-für-Schritt-Anleitung zu Ollama und Open WebUI. Die Anbindung an bestehende Systeme behandelt der Beitrag zur Integration lokaler KI.
Häufige Fragen zu lokaler KI und Datenschutz
Sendet Ollama meine Prompts an den Hersteller? Bei lokalen Modellen nicht. Ollama verbindet sich zwar für Modellempfehlungen, Updates und Downloads mit seinen Servern, die Inhalte Ihrer Chats sind darin aber nicht enthalten. Anders ist es bei Cloud-Modellen, erkennbar am Suffix cloud.
Reicht OLLAMA_NO_CLOUD, um Ollama vollständig offline zu betreiben? Die Variable schaltet Cloud-Modelle und Websuche ab, laut Quellcode entfällt auch der regelmäßige Abruf der Modellempfehlungen. Für einen Server ohne jede Außenverbindung braucht es zusätzlich eine Firewall-Regel für ausgehenden Verkehr und Modelle, die vorab auf anderem Weg bereitgestellt werden.
Wie mache ich Ollama im Firmennetz sicher erreichbar? Lassen Sie Ollama auf 127.0.0.1 lauschen. Ihre Beschäftigten arbeiten über Open WebUI mit eigener Benutzerverwaltung, Skripte und andere API-Clients über einen Reverse Proxy mit Authentifizierung oder über ein VPN, das nur berechtigte Geräte zulässt.
Weitere Beiträge aus dem Blog
Diese Beiträge könnten Sie ebenfalls interessieren:
Gratis-Download
Kostenloses Whitepaper: Lokale KI für Unternehmen
Ehrliche Entscheidungsgrundlage für KMU: Wann sich lokale KI rechnet, mit konkreten Kosten, DSGVO-Einordnung und Umsetzungsfahrplan.
KI-Expertise für Ihr Unternehmen
Sie möchten wissen, wie künstliche Intelligenz auch in Ihrem Unternehmen Mehrwert schaffen kann? In einem kostenlosen Erstgespräch besprechen wir Ihre Möglichkeiten.
Oder schreiben Sie uns direkt: [email protected] | +43 660 31 96 763